L'IA disait qu'une bonne politique ne couvrait rien : construire un assistant de conformité digne de confiance
La première fois que mon scanner de documents a lu une politique vraiment bonne, il m'a répondu qu'elle ne couvrait rien.
Zéro contrôle entièrement couvert. Des dizaines marqués comme partiels. Une politique de continuité d'activité bien écrite, le genre qu'un auditeur lit avec plaisir, ressemblait à un échec.
Le scanner n'était pas en panne. Il répondait à la mauvaise question.
Et corriger cette question a été la décision la plus importante de tout le projet.
Voici ce que j'ai construit, ce que l'IA fait et ne fait pas, et pourquoi la leçon dépasse largement la conformité.
D'abord, c'est quoi une évaluation de conformité
Si vous n'en avez jamais vécu une, voici la version courte.
Une évaluation de conformité mesure une organisation par rapport à un référentiel. En cybersécurité, c'est souvent le NIST Cybersecurity Framework. En continuité d'activité, c'est ISO 22301. Chaque référentiel est une longue liste de contrôles : ce qu'une organisation bien tenue devrait avoir en place. Le NIST CSF 2.0 en compte à lui seul 106.
Pour chaque contrôle, un consultant pose des questions, examine des preuves et attribue une note. Ensuite, les notes deviennent un plan : quoi corriger en premier, qui s'en charge, et à quoi ressemble « mieux ».
Les preuves, ce sont le plus souvent des documents : politiques, plans, procédures, comptes rendus de tests. Les lire attentivement représente une bonne partie du travail.
Mon client est un cabinet de conseil informatique qui fait ce travail pour ses propres clients, dans un portail web que ses consultants utilisent déjà.
Le portail gérait très bien la structure. Ce qu'il ne faisait pas, c'était aider à réfléchir. Et c'est dans la réflexion que partent les heures.
Que veut vraiment dire ce contrôle pour une entreprise de cette taille ? Comment le noter ? Quelle preuve demander ? La politique que le client vient d'envoyer le couvre-t-elle, ou se contente-t-elle d'en parler ?
Multipliez ces questions par une centaine de contrôles et vous obtenez le vrai coût d'une évaluation.
Pas les clics. La lecture et le jugement.
De l'aide là où le consultant travaille déjà
Je voulais que l'aide vive dans le portail, à côté du travail. Pas d'outil à part, pas de copier-coller vers un chatbot ouvert dans un autre onglet.
C'est donc là que je l'ai installée.
À côté de chaque question, il y a maintenant un bouton Ask AI. Il sait sur quel contrôle vous êtes : vous pouvez lui demander ce que le contrôle signifie, comment le noter ou quelles preuves chercher, et obtenir une réponse dans le bon contexte.
Il parle aussi la langue du portail. Pour la continuité d'activité, il s'appuie sur les mêmes niveaux de maturité que ceux affichés à l'écran, si bien que ses réponses collent aux notes que le consultant s'apprête à donner.
Sur l'évaluation entière, une analyse fait ressortir les points les plus faibles, les écarts et une série d'actions recommandées. Le consultant peut ajouter chacune d'elles au plan d'amélioration, avec un responsable. Ou les ignorer.
Sur la page de synthèse, un petit assistant placé à côté de chaque note explique pourquoi elle se situe à ce niveau, quels contrôles la tirent vers le bas et ce qu'il faudrait pour passer au niveau suivant.
Et pour les documents, un scan : vous déposez la politique ou la procédure d'un client et vous la confrontez au référentiel.
Les trois premiers consistaient à mettre de bonnes réponses au bon endroit.
Le scan, lui, m'a appris quelque chose.
Le jour où le scanner a recalé une bonne politique
La première version du scan faisait ce qui semblait évident : prendre le document, prendre tous les contrôles du référentiel, et vérifier le document contre chacun d'eux.
Rigoureux. Systématique. Complètement faux.
Une politique de continuité d'activité n'est pas censée contenir vos procédures d'incident, vos contrats fournisseurs ou vos comptes rendus d'exercices. Elle fixe un cap. Elle énonce des engagements. Elle dit qui est responsable de quoi. C'est tout son rôle.
Alors quand on confronte une politique à tous les contrôles d'une norme, elle reste en deçà sur presque tous. Pas parce qu'elle est mauvaise, mais parce qu'elle n'a jamais eu vocation à les couvrir. Et le scanner marquait chacun de ces contrôles comme partiel ou absent.
D'où le zéro à l'écran.
Le résultat se défendait sur le papier et ne servait à rien en pratique. Personne ne fait confiance à un outil qui recale les bons documents. Et aucun consultant ne peut remettre à son client un rapport expliquant que sa politique, pourtant solide, ne couvre rien.
Une IA qui recale les bons documents fait pire que pas d'IA du tout.
Poser la bonne question
La solution n'était pas un meilleur prompt. C'était une meilleure question.
Pas « ce document satisfait-il le référentiel ? », mais « à quoi sert ce document, et le fait-il bien ? »
Le scan fonctionne donc désormais de deux façons.
Contre un seul contrôle. Le consultant choisit un contrôle, ou clique directement sur l'icône de scan placée à côté, et le document n'est jugé que sur ce que ce contrôle exige. C'est exactement la façon dont un consultant raisonne : j'ai cette politique, est-ce qu'elle prouve ce contrôle ?
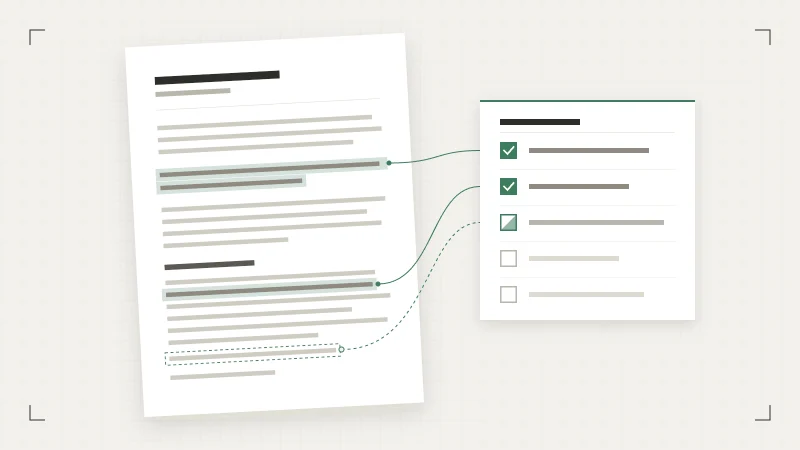
Sur le document entier. Si vous ne choisissez aucun contrôle, le scan commence par déterminer de quel type de document il s'agit et quels contrôles il a été écrit pour couvrir. Il évalue ceux-là, et seulement ceux-là. Tout le reste est listé comme hors périmètre pour ce document.
Hors périmètre, ce n'est pas un écart. Cette seule distinction a changé la lecture des résultats.
Chaque résultat se lit comme une courte revue : un verdict, le nombre d'éléments requis trouvés pour ce contrôle, une citation pour chacun, et une seule ligne sur ce qui manque pour le satisfaire pleinement. Les bonnes pratiques apparaissent aussi, mais comme des conseils. Elles ne font jamais baisser le verdict.
Il restait un piège, plus subtil.
Une politique dit généralement qu'un plan de continuité doit exister. Au début, un test a montré le scan lisant cette phrase et déclarant tranquillement le contrôle du plan satisfait.
Il ne l'est pas. Une politique qui dit que vous aurez un plan n'est pas le plan.
Désormais, quand un document se contente d'exiger qu'une chose existe, le contrôle apparaît comme soutenu par ce document, sans verdict. La preuve de ce contrôle, c'est le plan lui-même, et le résultat le dit clairement.
Ce que l'IA ne décide jamais
C'est la partie à laquelle je tiens le plus, dans chaque projet.
L'IA lit vite, explique, rédige et oriente. Elle ne décide pas.
Elle ne fixe jamais une note. Les notes appartiennent au consultant.
Elle n'approuve jamais un document. Chaque résultat de scan le rappelle : il s'agit d'une pré-vérification assistée par IA, pas d'un avis d'audit.
Rien n'entre dans le plan d'amélioration sans qu'un consultant l'y ajoute.
Et quand le scan affirme qu'un document couvre quelque chose, il doit le prouver. Chaque citation qu'il avance comme preuve est vérifiée mot pour mot dans le document. Si la phrase n'y figure pas vraiment, elle est signalée pour qu'une personne vérifie, et jamais présentée comme une preuve.
Même chose pour le verdict. Conforme, partiellement conforme ou non conforme : ce n'est pas l'avis de l'IA. Le verdict est calculé par des règles fixes, à partir des éléments requis réellement trouvés. Les mêmes constats donnent donc toujours le même verdict.
La constance comptait autant que la justesse. Lors des premiers essais, la même politique pouvait ressortir avec des résultats légèrement différents d'un passage à l'autre. C'est fatal pour la confiance : scannez deux fois un document, obtenez deux réponses, et vous ne croirez ni l'une ni l'autre. Désormais, chaque contrôle est toujours vérifié contre la même liste d'éléments requis, et le verdict vient des règles, pas de l'humeur du modèle.
Ce n'est pas de la méfiance envers l'IA. C'est savoir ce qu'elle fait bien.
Un modèle de langage lit remarquablement bien, et devine avec beaucoup trop d'aplomb. Vous voulez le premier talent sans le second.
Où on en est
L'assistant est maintenant entre les mains du client, sur son propre serveur, en test sur de vraies évaluations.
En test, la même bonne politique qui ne couvrait soi-disant rien est ressortie presque conforme à son contrôle : tous ses éléments requis bien présents sauf un, une citation pour chacun, et le dernier seulement sous-entendu, désigné comme le point à corriger. J'ai relancé le scan trois fois. Trois fois la même réponse.
Une politique portant sur un sujet sans aucun rapport est ressortie comme hors du champ de la norme, au lieu d'être forcée dans des correspondances. Une version précédente se montrait moins prudente : elle avait rattaché ce même document à huit contrôles, et quatre de ses citations n'existaient nulle part dans le texte.
C'est exactement à ça que sert la vérification mot pour mot.
Pour une politique de taille courante, une vérification contre un seul contrôle prend moins d'une minute et coûte environ trois centimes de dollar américain en usage d'IA.
Rien de tout cela ne remplace le consultant. Il obtient une première lecture qu'il peut vérifier, et davantage de temps pour la partie que lui seul sait faire.
Ça n'a rien à voir avec la conformité
Retirez les référentiels et le vocabulaire, et vous retrouvez ce schéma partout.
Un manuel qualité confronté à une norme de certification. Des politiques RH relues à la lumière d'une nouvelle loi. Des questionnaires fournisseurs comparés à vos exigences de sécurité. Des contrats passés au crible d'une check-list. Dès qu'une personne lit un document pour décider s'il respecte une liste d'exigences, la même approche fonctionne.
Laissez l'IA lire et expliquer. Laissez le code vérifier les preuves et appliquer les règles. Laissez une personne trancher.
Le plus difficile, c'est rarement l'IA. C'est de décider ce qu'elle a le droit de dire, ce qu'elle doit prouver et ce qui reste entre les mains d'une personne. Une fois ces règles posées, le reste relève de l'ingénierie.
Et jugez chaque document sur ce pour quoi il est fait. Pas sur tout à la fois.
Racontez-moi le vôtre
Si votre équipe passe des heures à lire des documents au regard d'une norme, d'une check-list ou d'un ensemble de règles, j'aimerais en entendre parler.
Que vérifiez-vous, combien de temps cela vous prend-il, et où se joue vraiment le jugement ?
Écrivez-moi.